---
url: https://sugarat.top/bigWeb/browser/cache.md
---
# 缓存机制
## 缓存定义
用于存储数据的硬件或软件的组成部分,以使得后续更快访问相应的数据
缓存中的数据可能是提前计算好的结果或者数据的副本
## 浏览器缓存
浏览器端(客户端)保存数据用于快速读取或避免重复资源请求的优化机制
缓存是一种简单高效的性能优化方式,可以显著减少网络传输所带来的性能损耗
对于一个数据请求来说,可以分为三个步骤
1. 发起请求
2. 后端处理
3. 浏览器响应
浏览器缓存可以在第一和第三步骤中优化性能
* 直接使用缓存而不发起请求
* 发起了请求但后端存储的数据和缓存的数据一致,那么就没有必要再将数据回传回来,这样就减少了响应数据的传输
## 缓存位置
从缓存位置上来说分为四种,并且各自有优先级,当依次查找缓存且都没有命中的时候,才会去请求网络
1. Service Worker
2. Memory Cache
3. Disk Cache
4. Push Cache
### Service Worker
Service Worker 是运行在浏览器背后的独立线程,一般可以用来实现缓存功能
使用 Service Worker的话,传输协议必须为 HTTPS,因为 Service Worker 中涉及到请求拦截,所以必须使用 HTTPS 协议来保障安全
**步骤**
1. 注册 Service Worker
2. 监听到 install 事件以后就可以缓存需要的文件
3. 下次用户访问的时候就可以通过拦截请求的方式查询是否存在缓存
* 是:可以直接读取缓存文件
* 否:请求数据
Service Worker 的缓存与浏览器其他内建的缓存机制不同,它可以让我们自由控制缓存哪些文件、如何匹配缓存、如何读取缓存,并且缓存是持续性的
当 Service Worker 没有命中缓存的时候,就需要去调用 fetch 函数获取数据
也就是说,当没有在 Service Worker 命中缓存的话,会根据缓存查找优先级去查找数据
但是不管是从 Memory Cache 中还是从网络请求中获取的数据,浏览器都会先从 Service Worker 中获取的内容
目录结构
```js
serviceWorker/
├── index.css
├── index.html
├── index.js
└── sw.js
```
index.css
```css
h1{
color:red;
}
```
index.html
```html
Service Worker Test
```
index.js
```js
console.log('index.js')
// 注册
if (navigator.serviceWorker) {
console.log('开始注册service Worker')
navigator.serviceWorker
.register('sw.js')
.then(function (registration) {
console.log('service worker 注册成功')
})
.catch(function (err) {
console.log('servcie worker 注册失败')
})
}
```
sw.js
```js
/**
* 监听 `install` 事件,回调中缓存所需文件
*/
self.addEventListener('install', e => {
e.waitUntil(
caches.open('my-cache').then(function (cache) {
return cache.addAll(['./index.html', './index.js', './index.css'])
})
)
})
// 拦截所有请求事件
// 如果缓存中已经有请求的数据就直接用缓存,否则去请求数据
self.addEventListener('fetch', e => {
e.respondWith(
caches.match(e.request).then(function (response) {
if (response) {
return response
}
console.log('fetch source')
})
)
})
```
显示效果
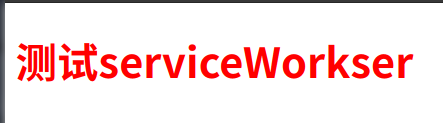
第一次运行输出

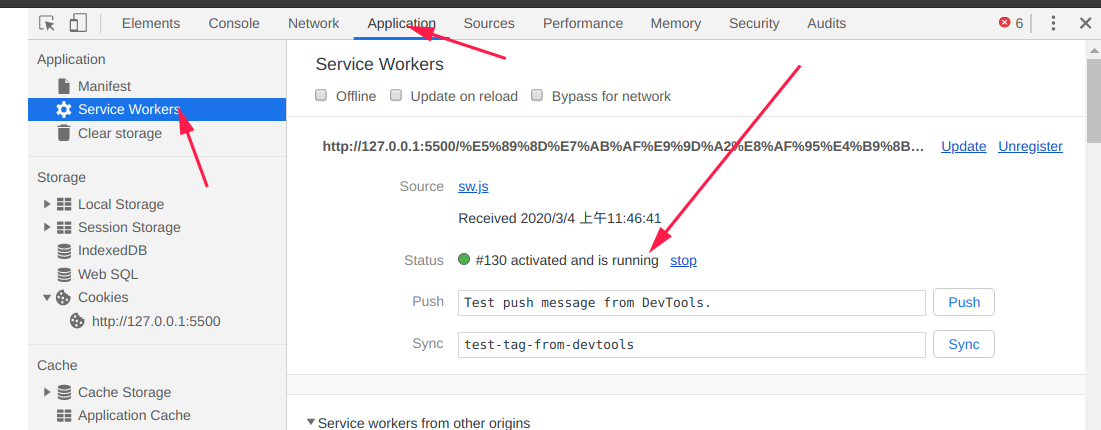
查看Service Worker(生效)
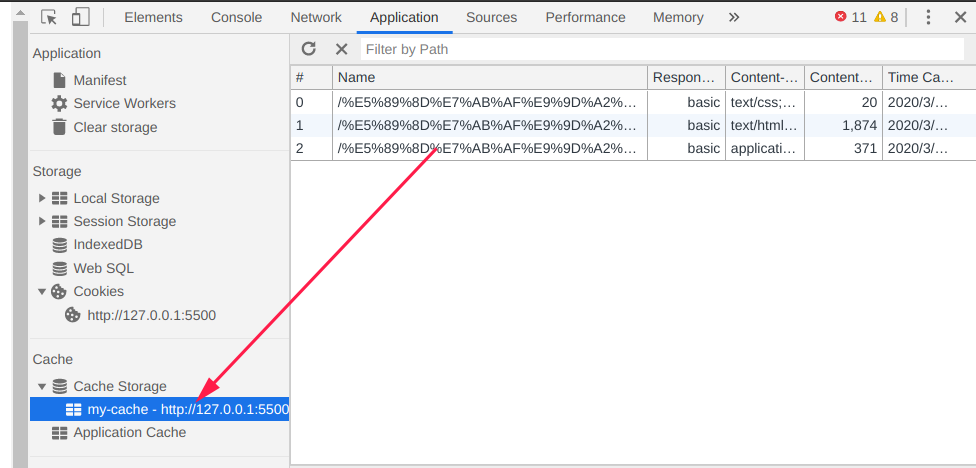
查看cache(里面有我们缓存的文件)
我们改动index.css,然后保存
```css
h1{
color:blue;
}
```
显示效果(不发生改变,说明是 我们设置的service Worker生效了)

查看控制台中的network
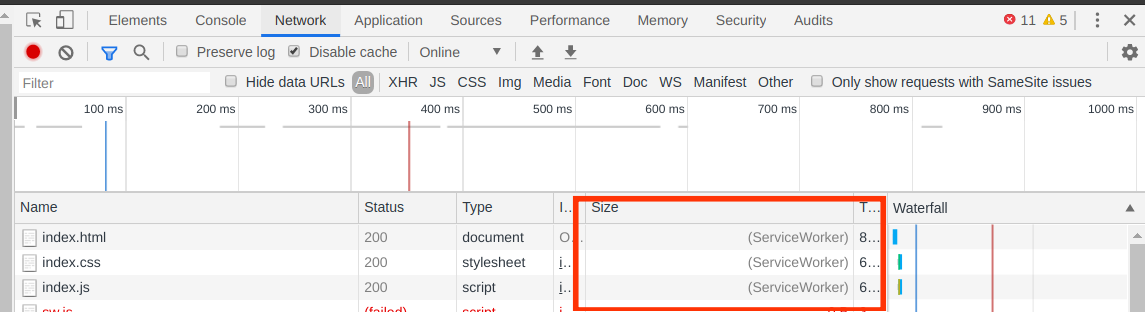
查看控制台(打印了`fetch source`,说明是从service worker中取的)
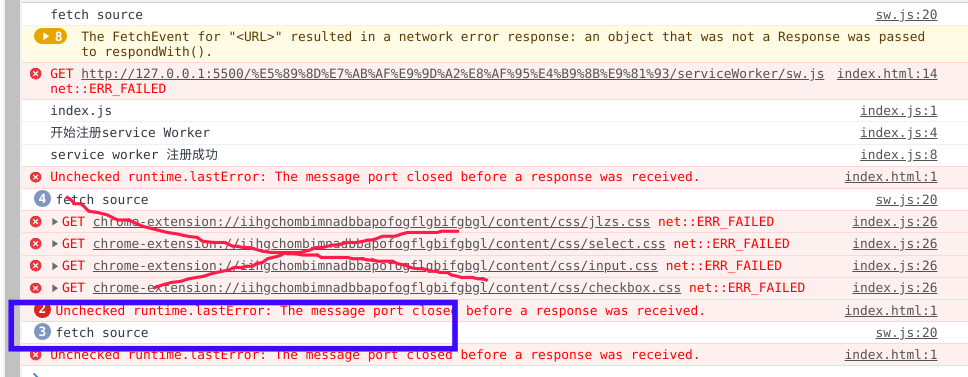
以上就是ServiceWorker的使用方式
相关资源:
* Google 官方[workbox](https://developers.google.com/web/tools/workbox)
* [developers文档:Service Worker](https://developers.google.com/web/fundamentals/primers/service-workers/)
### Memory Cache
Memory Cache 也就是内存中的缓存,读取内存中的数据比磁盘快
内存缓存虽然读取高效,但是缓存持续性很短,会随着进程的释放而释放。一旦关闭 Tab 页面,内存中的缓存就被释放了
当我们访问过页面以后,再次刷新页面,可以发现很多数据都来自于内存缓存
随便打开一个网页看看
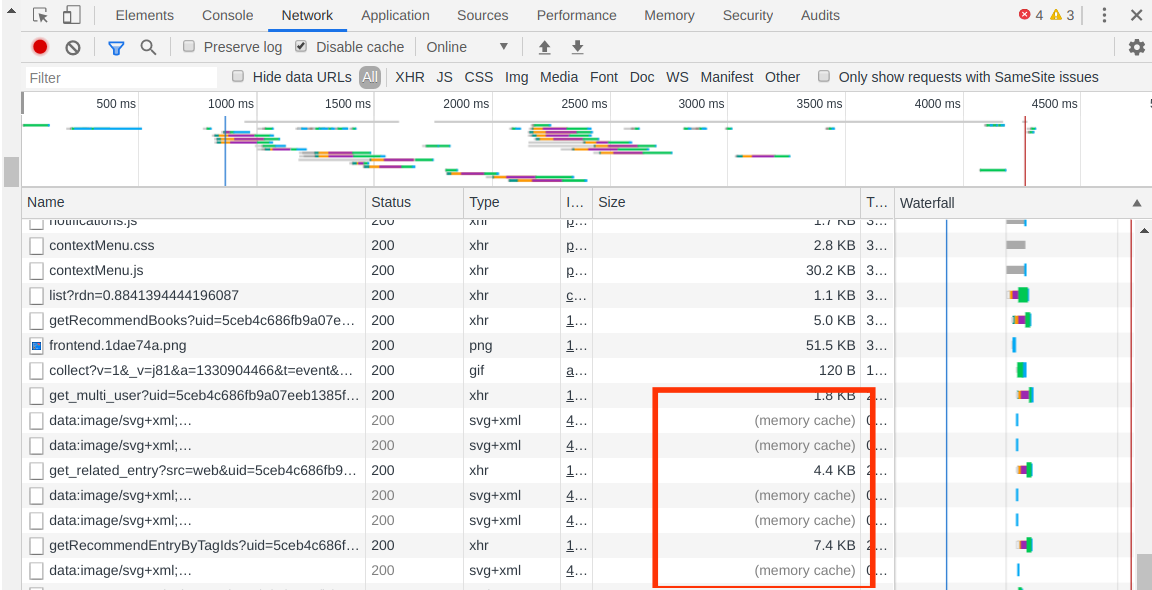
**浏览器会把哪些文件放入内存:question:**
* 浏览器会把解析完成的js与css放入内存中
**特点**
* 快速读取:将编译解析后的文件,直接存入该进程的内存中,占据该进程一定的内存资源,以方便下次运行使用时的快速读取
* 时效性:一旦该进程关闭,则该进程的内存则会清空
### Disk Cache
Disk Cache 也就是存储在硬盘中的缓存,读取速度慢点,但是什么都能存储到磁盘中,比之 Memory Cache 胜在容量和存储时效性上
在所有浏览器缓存中,Disk Cache 覆盖面基本是最大的
可以根据 HTTP Herder 中的字段判断哪些资源需要缓存,哪些资源可以不请求直接使用,哪些资源已经过期需要重新请求
即使在跨站点的情况下,相同地址的资源一旦被硬盘缓存下来,就不会再次去请求数据
**哪些资源会被放入磁盘:question:**
* 对于大文件来说,大概率是不存储在内存中的,反之优先
* 当前系统内存使用率高的话,文件也会优先存储进硬盘
**特点**
* 直接将缓存写入硬盘文件中
* 读取需要对硬盘上文件进行I/O操作,然后重新解析该缓存内容,读取复杂,速度比内存缓存慢
* 文件类型覆盖面大
* 容量大,存储时间可控
### Push Cache
Push Cache 是 HTTP2 协议新增的内容
当以上三种缓存都没有命中时,它才会被使用。并且缓存时间也很短暂,只在会话(Session)中存在,一旦会话结束就被释放。
**特点**
* 所有的资源都能被推送,但有一定的兼容性问题
* 可以推送 no-cache 和 no-store 的资源
* 一旦连接被关闭,Push Cache 就被释放
* 多个页面可以使用相同的 HTTP/2 连接,即可以使用同一份缓存
* Push Cache 中的缓存只能被使用一次
* 浏览器可以拒绝接受已经存在的资源推送
当所有缓存都没有命中时,就会发起网络请求来获取资源
## 缓存策略
* 强缓存
* 协商缓存
优先级较高的是强缓存,当强缓存失效的情况下,才会走协商缓存流程
都是通过设置 HTTP Header 来实现的
### 强缓存
#### 特点
1. 不会向服务器发送网络请求,直接从缓存中读取资源
2. 请求返回200的状态码
3. 在devtools的network选项卡可以看到size显示from disk cache或from memory cache
#### 设置方法
通过两种 HTTP Header 实现
* Expires
* Cache-Control
**二者区别**
1. Expires 是RFC 2616(HTTP/1.0)协议中和网页缓存相关字段
2. Cache-Control 是HTTP/1.1 中实现缓存机制的指令
3. Cache-Control优先级高于Expires
#### Expires
使用举例:
```json
Expires : Wed Mar 04 2020 13:33:10 GMT
```
用来指定资源的到期时间,表示资源在
* 这个时间之前无需发起网络请求,直接使用缓存的资源
* 这个时间之后失效,需要重新发起网络请求获取
**缺陷:** 受限制与本地时间,可以通过修改本地时间致其失效
#### Cache-Control
使用举例:
```json
Cache-control: max-age=30
```
表示资源会在 30 秒后过期,需要再次请求,max-age是距离请求发起的时间的秒数
Cache-Control 生于 HTTP/1.1,**优先级高于** Expires 。
可以在`请求头`或者`响应头`中设置,并且可以组合使用多种指令
**常见指令**
| 指令 | 作用 |
| :-----------------: | :-----------------------------------: |
| public | 响应可以被服务端或者客户顿缓存 |
| **private** 默认值 | 响应只可以被客户端缓存 |
| max-age=30 | 缓存30s后过期需要重新请求 |
| s-maxage=30 | 覆盖max-age,作用一致,代理服务器才生效 |
| no-store | 不缓存任何响应 |
| no-cache | 资源能被缓存,但立即失效 |
| max-stale=30 | 30s内,即使缓存过期也使用该缓存 |
| min-fresh=30 | 希望30s内获取最新的响应 |
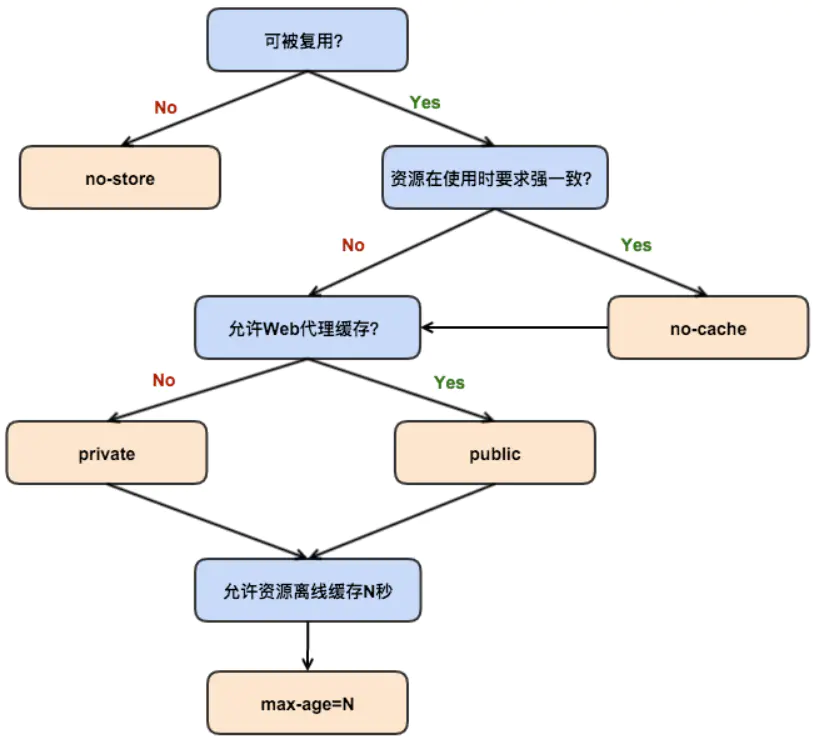
**特点** 优先级高于Expires,指令可以组合
### 协商缓存
协商缓存就是强缓存失效后,浏览器携带资源的缓存标识向服务器发起请求,由服务器根据缓存标识决定是否继续使用缓存的过程
当浏览器发起请求验证资源时,如果资源没有做改变,那么服务端就会返回 304 状态码,并且更新浏览器现有缓存有效期
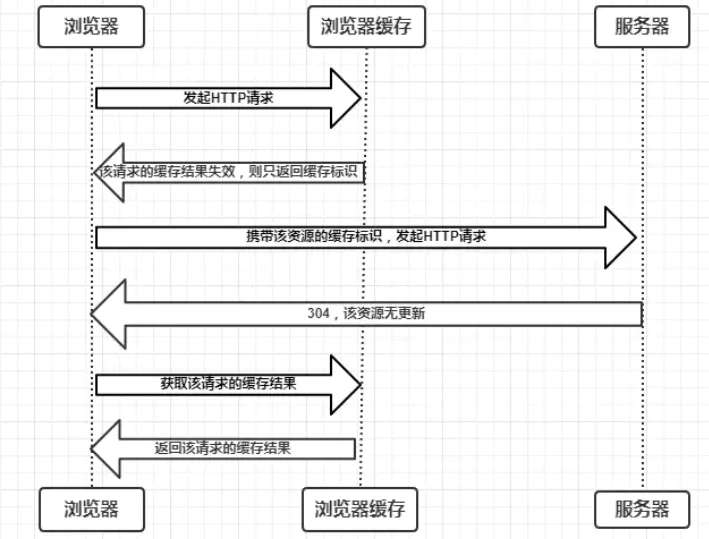
当资源失效时,返回 200 状态码和最新的资源
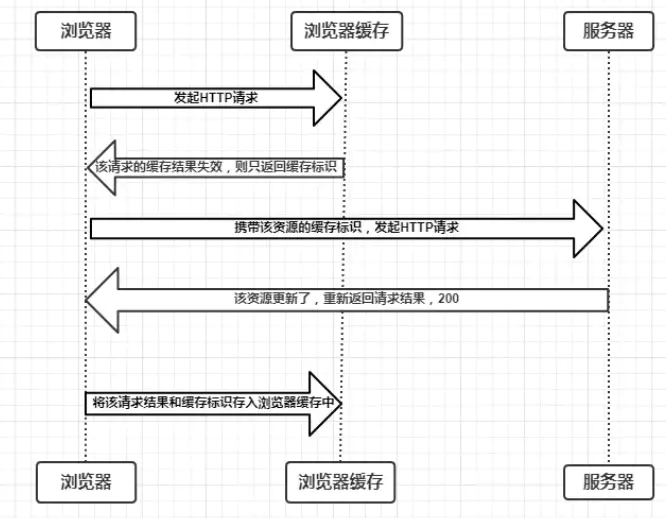
协商缓存可以通过设置两种 HTTP Header实现
* Last-Modified
* ETag
#### Last-Modified
浏览器发起请求访问目标资源,服务器在返回资源的同时,会在response header中添加 Last-Modified这个header,表示这个资源在服务器上的最后修改时间
浏览器下一次请求这个资源,浏览器检测到有 Last-Modified这个header,于是会添加If-Modified-Since这个header其值就是Last-Modified中的值
服务器再次收到这个资源请求,会根据 If-Modified-Since 中的值与服务器中这个资源的最后修改时间对比
* 若服务器的资源最后被修改时间不等于于If-Modified-Since中的值的话就会将新的资源发送回来
* 否则返回 304 状态码
**缺点:**
* 如果本地打开缓存文件,即使没有对文件进行修改,但还是会造成 Last-Modified 被修改,服务端不能命中缓存导致发送相同的资源
* Last-Modified 只能以秒计时,如果在不可感知的时间内修改完成文件,那么服务端会认为资源还是命中了,不会返回正确的资源
因为以上这些弊端,所以在 HTTP / 1.1 出现了 `ETag`
#### ETag
Etag是服务器在响应请求时,返回的当前资源文件一个唯一标识(由服务器生成),只要资源有变化,Etag就会重新生成
浏览器在向服务器发送请求时,会将上一次返回的Etag值放到请求头的If-None-Match字段里
服务端比较 If-None-Match 中的值跟目标资源的ETag是否一致
* 一致,响应状态码为304
* 不一致,响应状态码为200,并返回新的资源
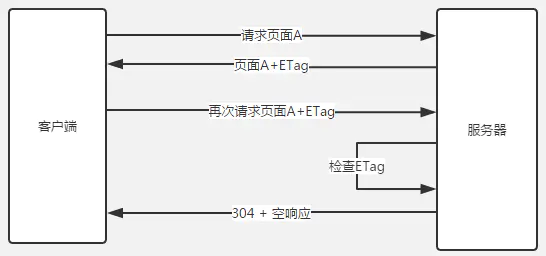
**特点:**
* ETag 优先级比 Last-Modified 高
* ETag 是服务端通过算法计算得出,需要损耗一定时间
#### 两者对比
* Etag/If-None-Match优先级高于Last-Modified/If-Modified-Since
* 即同时存在则只有Etag / If-None-Match生效
* 性能上,Last-Modified要优于Etag
* Last-Modified只需要记录时间
* Etag需要服务器通过算法来计算出一个hash值
* 在精确度上,Etag要优于Last-Modified
* Last-Modified的时间单位是秒,如果某个文件在1秒内被改变了多次,那么它的Last-Modified没有体现出来修改
* 文件只要发生改变,Etag就会改变
## 执行流程
1. 强制缓存优先于协商缓存进行
* 若强制缓存(Expires和Cache-Control)生效则直接使用缓存
* 若不生效则进行协商缓存(Last-Modified / If-Modified-Since与Etag / If-None-Match)
2. 协商缓存由服务器决定是否使用缓存
* 若协商缓存失效,那么代表该请求的缓存失效,响应200,返回新的资源和缓存标识,并存入浏览器缓存中
* 生效则响应304,表示继续使用现有缓存
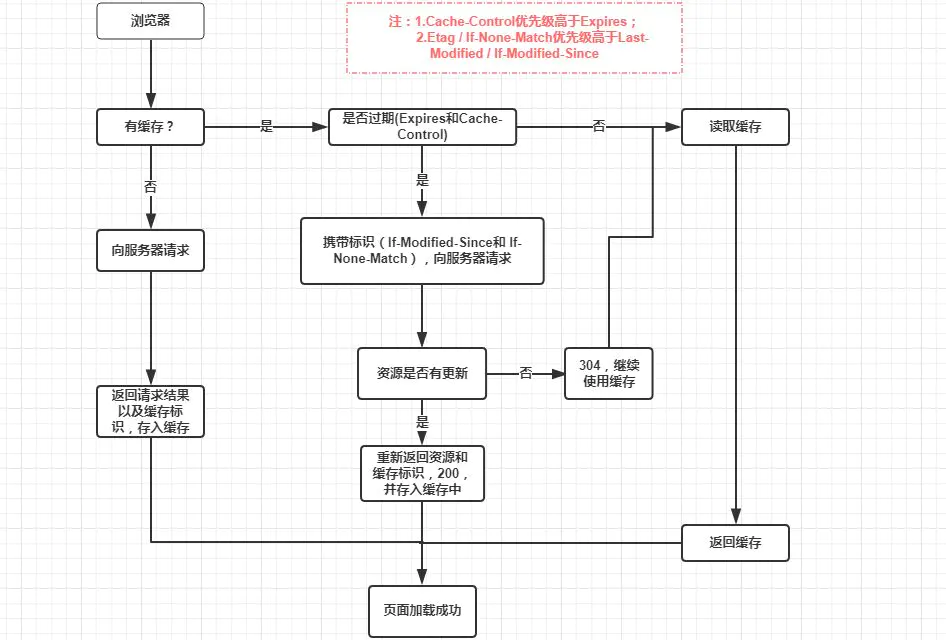
**如果什么缓存策略都没设置,那么浏览器会怎么处理:question:**
对于这种情况,浏览器会采用一个`启发式的算法`
取响应头中的 Date 减去 Last-Modified 值的 10% 作为缓存时间
## 缓存策略应用场景
### 1. 频繁变动的资源
1. 首先使用 `Cache-Control: no-cache`,使浏览器每次都请求服务器
2. 配合 ETag 或 Last-Modified 来验证资源是否过期
这样的做法虽然不能节省请求数量,但是能显著减少响应数据大小
### 2. 代码文件
缓存除`HTML`外的文件
一般来说,现在都会使用工具来打包代码,那么就可以对**HTML引用的静态资源的文件名进行哈希处理**,只有当文件内容发生修改后才会生成新的文件名
因此可以给代码文件设置缓存有效期一年Cache-Control: max-age=31536000,这样只有当`HTML`文件中引入的文件名发生了改变才会去下载最新的代码文件,否则就一直使用缓存。
:::tip 参考
* [简书 - 深入理解浏览器的缓存机制](https://www.jianshu.com/p/54cc04190252)
* [思否 - 浏览器缓存原理以及本地存储](https://segmentfault.com/a/1190000017185195)
* [掘金小册 - 前端面试之道](https://juejin.im/book/6844733763675488269/section/6844733763742597127)
* [掘金 - 彻底理解浏览器的缓存机制](https://juejin.im/entry/6844903593275817998)
:::